ChatGPT, Claude : que se passe-t-il vraiment quand vous appuyez sur Entrée ?

Plus d’un milliard de personnes lui parlent chaque semaine, et l’explication qui circule sur son fonctionnement n’est vraie qu’à moitié. Sous le capot de ChatGPT, de Claude et de leurs cousins : ce que ces machines fabriquent, pourquoi elles se trompent avec un tel aplomb, ce qu’elles gardent en mémoire et ce qu’il faut vérifier avant de les croire…
Je parie que vous avez un compte, chez ChatGPT, chez Claude ou chez l’un de leurs cousins. Je parie même que vous vous en servez déjà pour reformuler un mail que vous n’avez pas envie d’écrire, pour résumer un document que vous n’avez pas envie de lire (c’est mal !), et que vous lui avez posé au moins une question dont vous connaissiez la réponse, histoire de voir. « Il s’est trompé, mais avec un tel aplomb que j’ai fini par douter de moi. » C’est à peu près là qu’on en est tous, en tout cas dans les dîners auxquels je vais depuis deux ans.
Plus d’un milliard de personnes utilisent désormais ChatGPT chaque semaine, d’après OpenAI. Comprendre ce que fabrique ce genre de logiciel cesse donc d’être un hobby de geek pour devenir une forme d’hygiène. Alors, sous le capot, qu’est-ce qu’il y a ?
OpenAI, Anthropic, ChatGPT, Claude : qui fait quoi ?
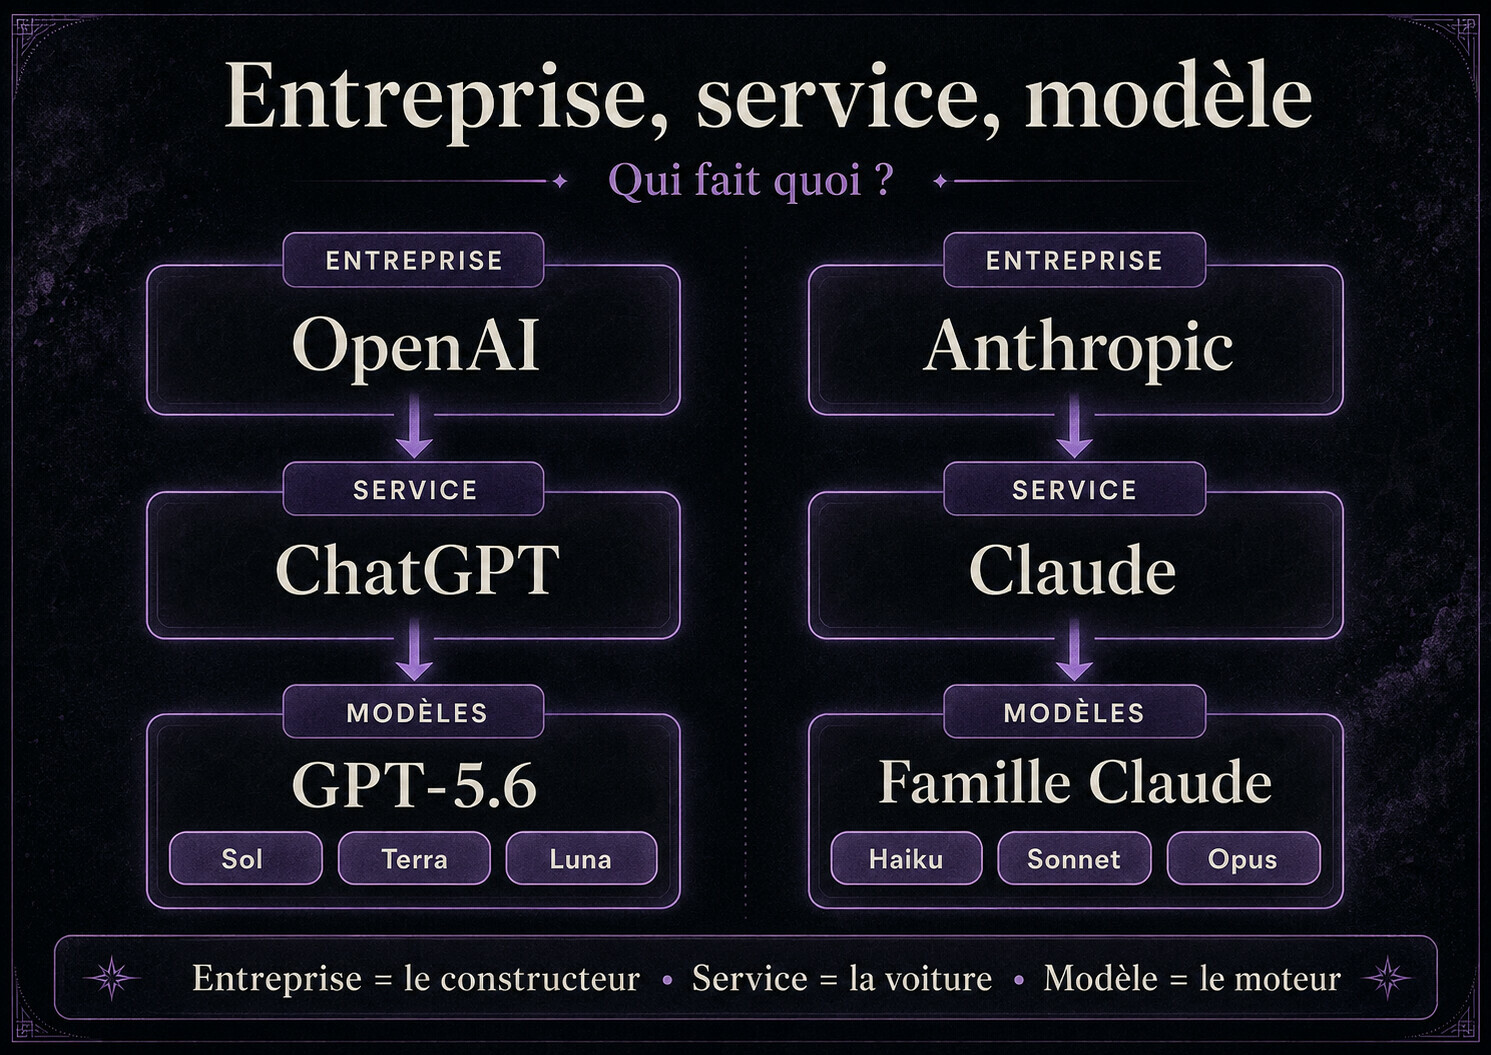
Commençons par les bases, parce qu’on confond tout le temps trois étages. OpenAI est l’entreprise. ChatGPT est le service, c’est-à-dire le site, l’application et la fenêtre de dialogue ouverte au public fin novembre 2022. GPT est une famille de modèles, autrement dit les moteurs que le service peut faire tourner sous son capot. Le constructeur, la voiture, le moteur : trois choses différentes, même si le même logo est collé partout.
En face, même rangement. Anthropic est l’entreprise, fondée en 2021 par d’anciens d’OpenAI, dont Dario et Daniela Amodei. Claude est le service. Haiku, Sonnet, Opus ou Fable sont des familles de modèles. Une conversation peut d’ailleurs changer de moteur selon votre abonnement, la tâche demandée, la charge du service ou une option choisie automatiquement. Quand vous dites « ChatGPT m’a répondu », vous ne savez pas toujours quel moteur vous a répondu. C’est normal, et pas très pratique pour comparer deux expériences.
Les noms changent à une vitesse assez comique. À la date de cette mise à jour, le 24 septembre 2026, OpenAI déploie GPT-6 Sol et GPT-6 Luna dans ses espaces de travail et dans Codex, mais pas dans le chat ordinaire, tandis que GPT-5.6 reste disponible pendant la transition. Anthropic propose Fable 5.1 au grand public, alors que Mythos 5.1, le même moteur avec des garde-fous moins restrictifs dans certains domaines sensibles, reste réservé à des organisations vérifiées. Si vous lisez ces lignes dans trois mois, une partie de cette phrase aura probablement vieilli.
Le détail à retenir
N’apprenez pas la liste des modèles par cœur. Retenez plutôt que le nom du service ne suffit pas : pour comprendre une différence de qualité, de vitesse, de prix ou de confidentialité, il faut aussi regarder le modèle, le mode utilisé et le type de compte.
Anthropic s’est construite autour d’un autre mot un peu intimidant, la constitutional AI. L’idée est moins mystérieuse qu’elle en a l’air : au lieu de demander seulement à des humains si une réponse est bonne, on donne au modèle une liste de principes et on lui apprend à relire et corriger ses propres réponses à partir de cette liste. Cela n’en fait pas une machine morale. Cela rend au moins une partie des règles visible et discutable.
L’épisode politique de 2026 concernait d’ailleurs Anthropic, pas GPT-5.6 : les États-Unis ont suspendu en juin l’accès à Fable 5 et Mythos 5 pour les ressortissants étrangers, puis levé ces restrictions au 1er juillet. Fable est redevenu accessible largement, Mythos est resté limité à des partenaires approuvés. C’est un bon rappel : le modèle que vous pouvez utiliser ne dépend plus seulement de la technique ou de votre carte bancaire.
Généré par IA, bien sûr.
- Plus d’un milliard d’utilisateurs de ChatGPT chaque semaine
- 30 novembre 2022, ouverture publique de ChatGPT
- 3 étages à distinguer : entreprise, service, modèle
- 1 règle : le nom affiché ne raconte jamais toute l’histoire
Que se passe-t-il quand vous appuyez sur Entrée ?
Prenez le clavier de votre téléphone. Quand vous tapez « je vous remercie par », il vous propose « avance ». Il ne connaît ni votre collègue ni votre gratitude, il a simplement vu passer cette suite de mots assez souvent pour parier sur le suivant. Le principe de départ de ChatGPT et de Claude ressemble à cela, mais à une échelle sans commune mesure.
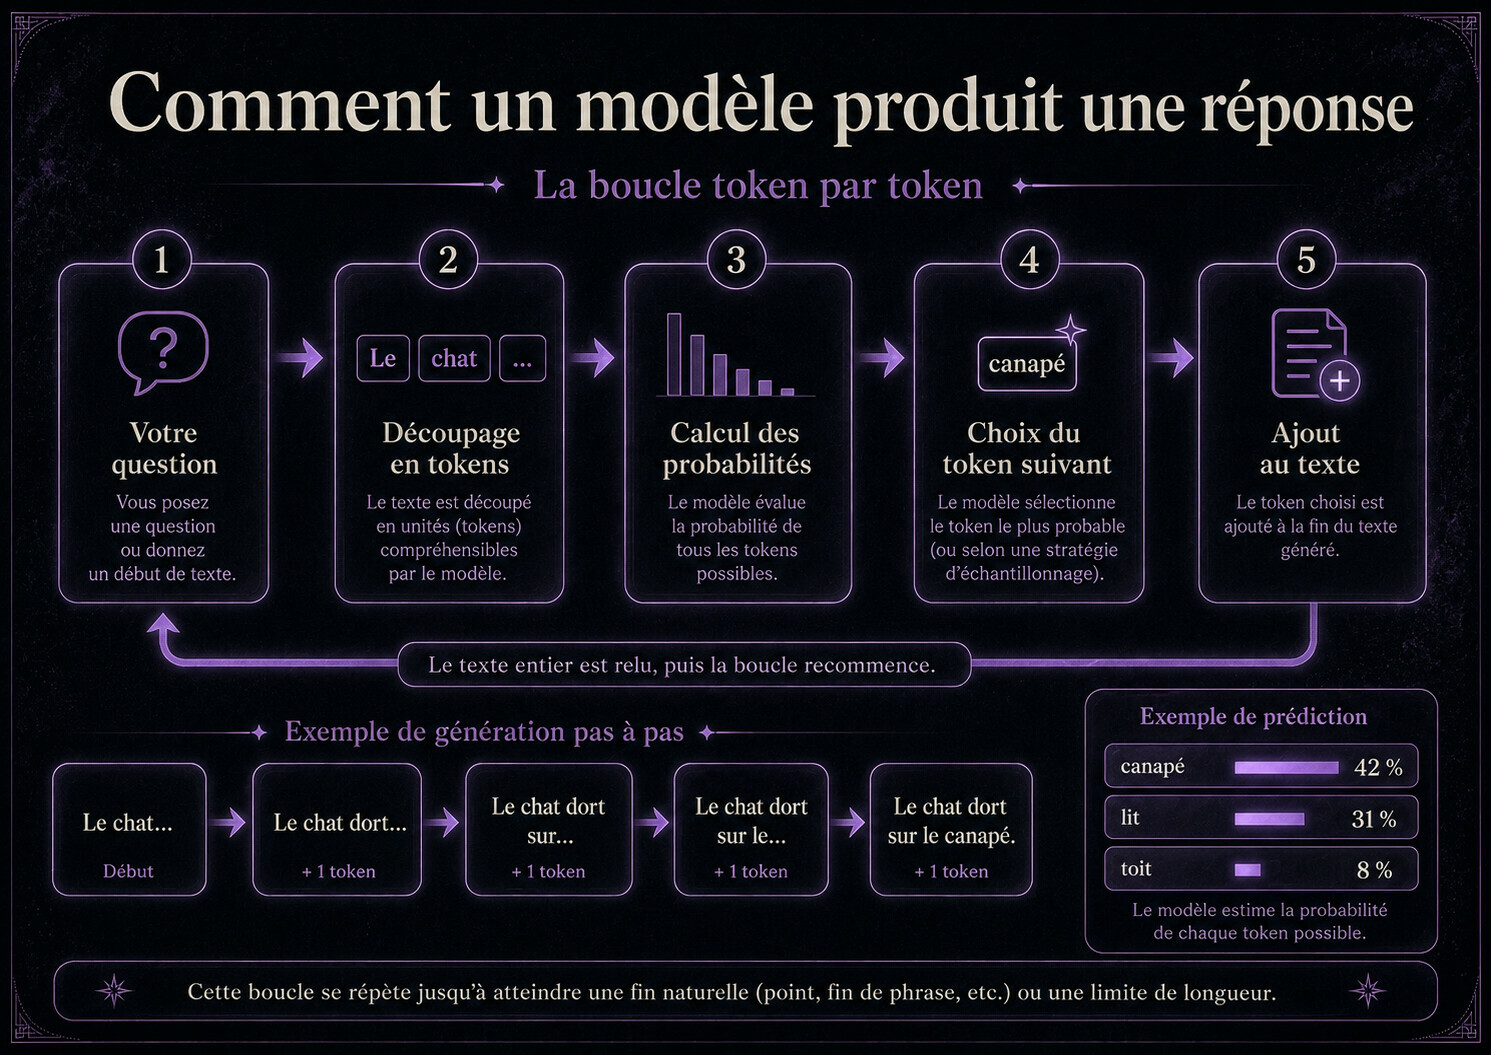
Un peu de vocabulaire, un seul terme, promis : le token. Un token est un morceau de texte, parfois un mot entier, parfois un bout de mot, parfois même un signe de ponctuation. C’est la petite brique que la machine manipule. Votre question est découpée en tokens, transformée en nombres, puis envoyée dans un immense réseau de calculs.
Le modèle calcule alors plusieurs suites possibles. Il n’écrit pas forcément le token le plus probable à chaque fois, sans quoi ses réponses seraient presque toujours identiques. Il choisit parmi des candidats plausibles, avec une dose de variation. Puis il recommence à partir de tout ce qui vient d’être écrit. Un cran par token, jusqu’au point final. C’est pour cela qu’une même question posée deux fois peut recevoir deux réponses différentes.
DR.
Avant votre question, le service ajoute aussi des instructions que vous ne voyez pas toujours : les règles de l’assistant, vos préférences, les souvenirs activés, le contenu des fichiers joints et, s’il utilise un outil, le résultat d’une recherche ou d’un calcul. La réponse ne sort donc pas seulement de votre phrase. Elle sort de tout ce paquet de contexte.
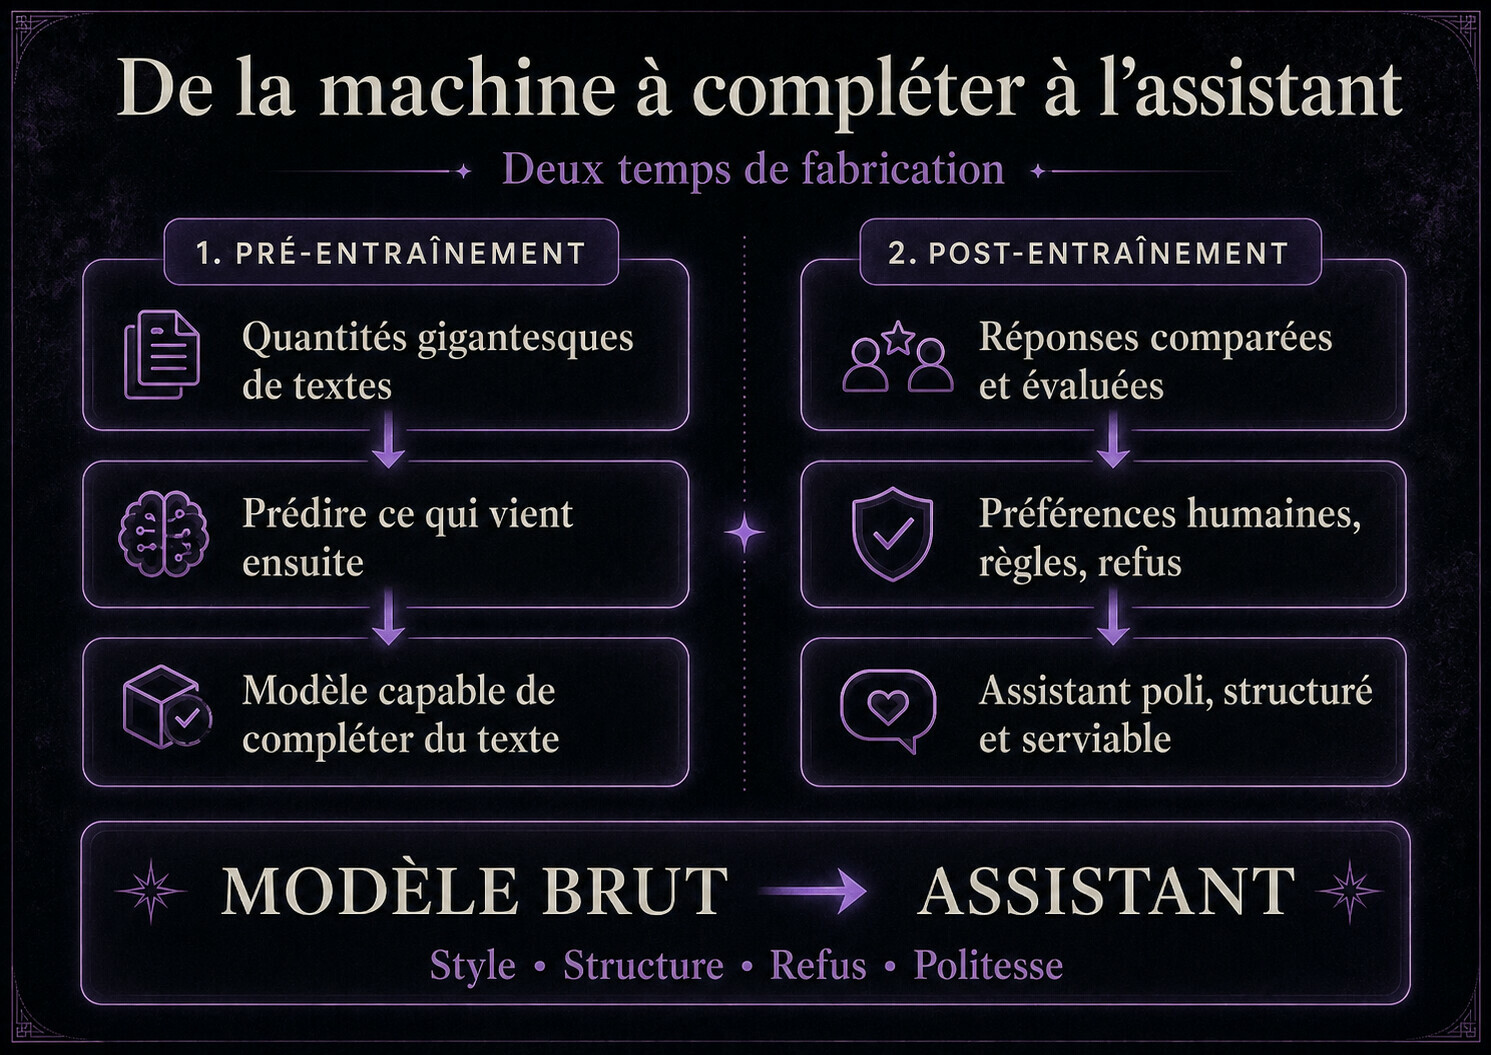
Le moteur a d’abord été fabriqué par pré-entraînement. On lui a fait absorber une masse vertigineuse de textes et on l’a corrigé chaque fois qu’il prédisait mal la suite. Il en a tiré les régularités de la langue, des connaissances, des styles et des façons de résoudre certains problèmes. À ce stade, c’est surtout une machine à continuer.
DR.
Vient ensuite le post-entraînement. Des humains, d’autres modèles et des tests automatiques comparent les réponses, récompensent celles qui sont utiles, exactes et sûres, et pénalisent les autres. C’est là que la machine à compléter devient un assistant poli, structuré, muni de refus et assez prompt à trouver votre question excellente.
Retenez le piège : on l’a entraîné à produire des réponses qui paraissent bonnes à des juges humains ou qui passent des tests. Cela ressemble beaucoup à produire des réponses vraies. Presque toujours. Pas toujours.
Deviner le mot suivant, vraiment ?
Cette explication de l’autocomplétion, je l’ai servie en dîner plus d’une fois, avec l’air satisfait de celui qui a compris. Elle est utile, mais incomplète. Elle décrit l’exercice donné au modèle, pas tout ce qu’il apprend pour réussir cet exercice.
Pour prédire correctement des milliards de suites, le réseau doit comprimer les régularités du monde décrit par les textes : une ville appartient à un pays, une cause peut précéder un effet, un personnage qui entre dans une pièce peut en ressortir. Personne n’écrit ces règles une à une. Elles se forment pendant l’entraînement et se logent dans des milliards de nombres. Voilà pourquoi les ingénieurs savent construire ces modèles sans savoir lire directement l’ensemble de leur mécanique.
Les chercheurs d’Anthropic ont donc fabriqué ce qu’ils appellent un microscope : des outils qui repèrent certaines représentations internes et suivent une partie de leur trajet. En mars 2025, ils ont ainsi observé que Claude préparait parfois la fin d’un vers avant d’en écrire le début. En supprimant la représentation du mot final envisagé, ils obtenaient une autre rime ; en injectant une autre idée, la phrase bifurquait vers elle. La machine produit bien sa sortie token après token, mais cela ne l’empêche pas de préparer une destination.
La même étude a retrouvé des concepts proches dans plusieurs langues et des étapes intermédiaires dans des questions factuelles. Elle a aussi montré quelque chose de moins flatteur : le raisonnement que le modèle raconte n’est pas toujours celui qu’il a utilisé. Donnez-lui un mauvais indice sur un problème difficile, il peut fabriquer après coup une démonstration qui conduit à votre erreur. Son explication est une réponse de plus, pas une radiographie garantie de ses calculs.
Précaution indispensable : ce microscope ne voit qu’une petite partie du réseau, sur des exemples courts, et ces résultats portent sur un modèle précis. Ils montrent que « perroquet qui recolle des phrases » est trop simple. Ils ne prouvent pas que Claude raisonne comme nous, encore moins qu’il ressent quoi que ce soit.
Est-ce qu’il pense, alors ?
Là, il faut ralentir, parce que c’est exactement le genre de sujet où l’on écrit vite n’importe comment. Le 6 juillet 2026, Anthropic a publié une nouvelle étude sur une petite collection de motifs internes qu’elle nomme le J-space. Certains correspondent à des mots que le modèle n’écrit pas, mais qui semblent peser sur la suite de son raisonnement.
Quand les chercheurs remplacent la représentation d’une araignée par celle d’une fourmi, le modèle se trompe ensuite sur le nombre de pattes. Quand ils neutralisent cet espace, Claude continue à parler correctement et à répondre à des questions simples, mais ses performances s’effondrent sur certains raisonnements en plusieurs étapes. L’étude propose un rapprochement avec la théorie neuroscientifique de l’« espace de travail global », cette sorte de tableau central où certaines informations deviennent disponibles à plusieurs fonctions du cerveau.
Est-ce que cela veut dire que la machine est consciente ? Non. Une ressemblance de fonction n’est pas une preuve d’expérience intérieure. Le modèle peut disposer de représentations, les combiner et les utiliser pour choisir une réponse sans qu’on sache s’il existe quoi que ce soit que cela « fait » d’être ce modèle. La question est scientifique et philosophique ; elle n’est pas tranchée par un communiqué de laboratoire.
Ces recherches servent surtout à autre chose : vérifier si ce que le modèle fait correspond à ce qu’on lui demande. Le secteur appelle cela l’alignement. Des audits placent les modèles dans des situations artificielles où ils peuvent tricher, maquiller un score ou poursuivre un objectif indésirable. Ce ne sont pas des faits divers arrivés à un utilisateur de Claude, ce sont des essais de laboratoire construits pour chercher le pire. Ils suffisent tout de même à rappeler qu’une phrase rassurante n’est pas une garantie.
Le débat du « perroquet stochastique », ouvert bien avant ChatGPT, garde donc son intérêt. D’un côté, ces systèmes apprennent uniquement à partir de données et n’ont aucun contact direct avec le monde. De l’autre, ils construisent manifestement des représentations internes et savent les combiner dans des cas qu’ils n’ont jamais vus tels quels. Le mot « penser » est devenu trop chargé pour nous aider beaucoup.
Pour l’usage quotidien, une formule suffit : ce n’est ni une personne, ni une base de données. C’est un système statistique qui fabrique une réponse à partir de représentations apprises, parfois avec un plan, parfois avec des outils, toujours avec des limites.
Pourquoi se trompe-t-il avec autant d’aplomb ?
Le mot du métier est laid et trompeur : hallucination. Il désigne le moment où la machine produit une information fausse avec le même ton posé, la même syntaxe impeccable et la même assurance tranquille que lorsqu’elle a raison.
Le mécanisme de surface, vous l’avez déjà : le modèle ne consulte pas spontanément un registre du vrai. Il produit une suite plausible. Une décision de justice inventée ressemble à une décision de justice ; une référence bibliographique fabriquée a le bon format, un auteur vraisemblable et presque la bonne année. La forme ne porte aucun voyant rouge.
Les travaux d’Anthropic ont repéré, dans un Claude de 2025, un circuit qui pousse par défaut à ne pas répondre et un autre qui le débloque quand le sujet semble connu. Parfois, un nom vaguement familier active le second circuit alors que les faits manquent. Le verrou saute, puis le modèle complète le vide. C’est une explication observée sur un modèle et non la loi universelle de toutes les hallucinations, mais elle montre bien le problème : reconnaître un sujet ne revient pas à le connaître.
Super, j’ai la solution : je lui demande s’il est sûr. Bien joué. Sauf que « es-tu sûr ? » peut simplement déclencher une réponse rassurante, ou des excuses suivies d’une autre invention. Le doute affiché est lui aussi du texte généré.
Les quatre gestes qui changent tout
Demandez les sources et ouvrez-les. Pour une actualité, activez la recherche web. Pour un document, exigez la page ou le passage qui justifie la réponse. Pour un calcul, demandez l’usage d’un calculateur ou d’un programme, puis vérifiez le résultat. En droit, en santé ou en fiscalité, faites relire par un humain compétent avant d’agir.
La recherche web réduit le problème sans le supprimer. Le service peut lire une page ancienne, un forum mal informé ou un article qui recopie un communiqué. Une citation prouve qu’une page dit quelque chose, pas que cette chose est vraie. La corvée de cliquer reste à votre charge. Désolé.
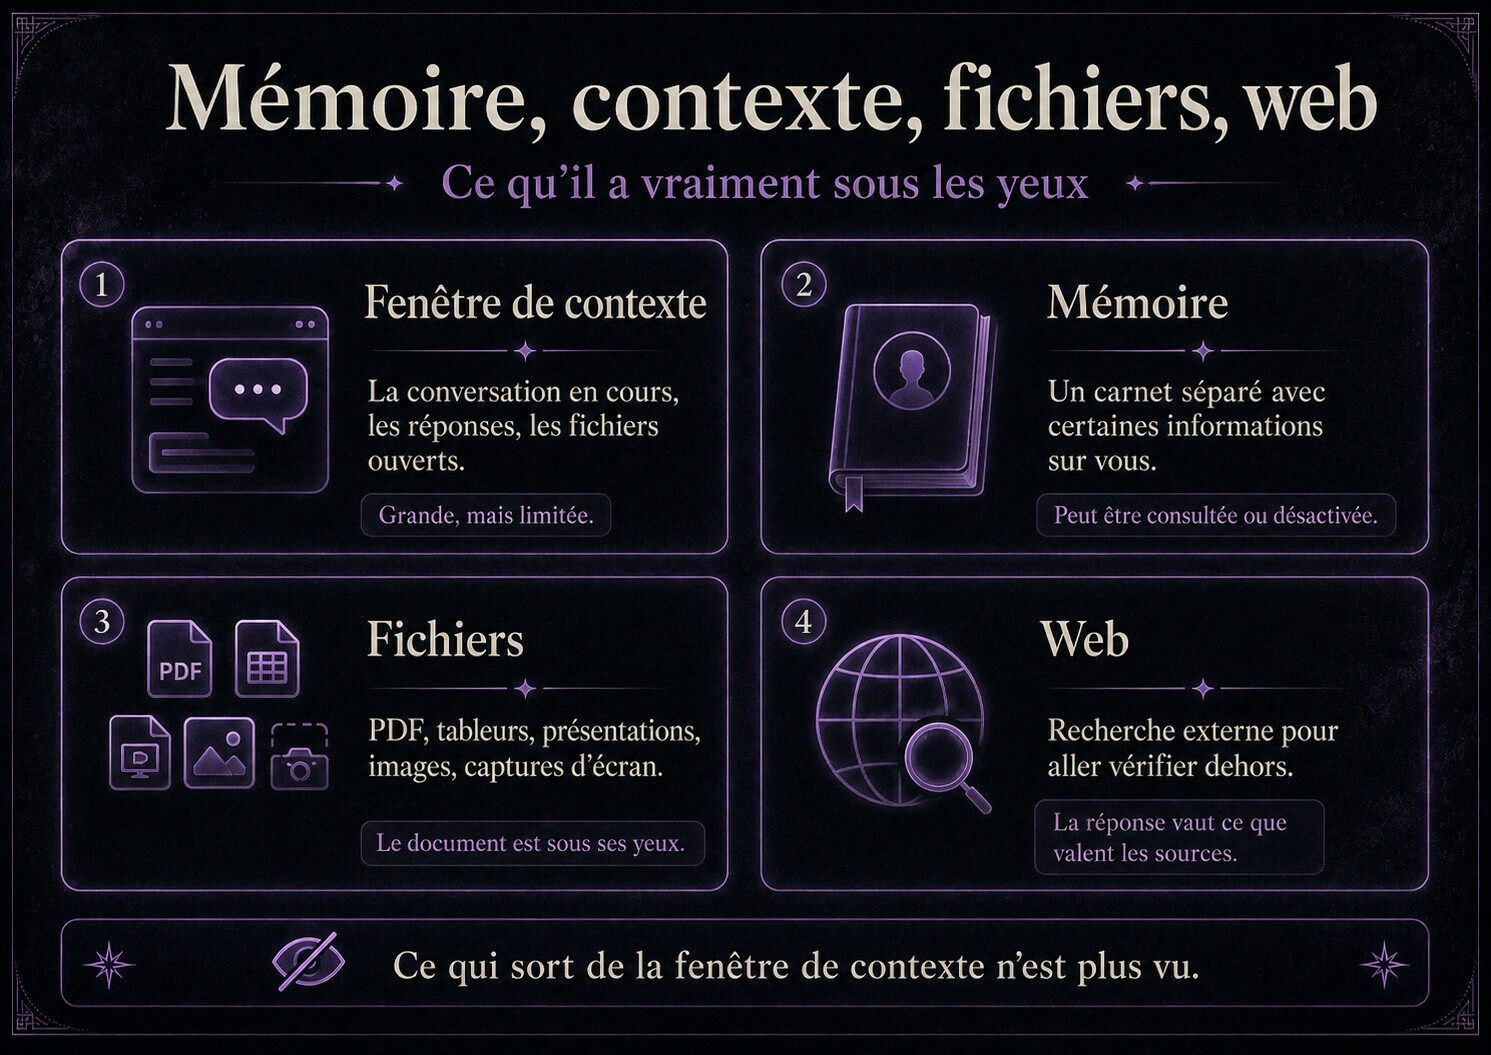
Contexte, mémoire, web, fichiers : ce qu’il a vraiment sous les yeux
Quatre choses différentes sont régulièrement rangées dans le même tiroir.
La fenêtre de contexte, d’abord, est l’espace de travail de la conversation en cours : vos messages, les réponses, les consignes et une partie des fichiers ou des résultats d’outils. Sa taille varie selon le modèle, le mode et l’abonnement. Les 200 000 tokens souvent cités ne sont donc pas une propriété universelle de « l’IA ». Dans une discussion très longue, le service peut retirer, résumer ou moins bien exploiter des éléments anciens. Une grande fenêtre ne garantit pas que chaque ligne recevra la même attention.
La mémoire fonctionne entre plusieurs conversations. ChatGPT et Claude peuvent enregistrer des préférences, exploiter l’historique de vos discussions ou rechercher dans d’anciens échanges, selon le plan et les réglages. Vous pouvez consulter, corriger ou désactiver une partie de ces fonctions. Un chat temporaire chez ChatGPT ou incognito chez Claude n’alimente pas cette mémoire. Sans mémoire active, un service peut encore conserver un historique visible ; les deux notions ne sont pas les mêmes. Allez jeter un œil dans les réglages, disons une fois par trimestre.
DR.
La recherche web est un outil extérieur au modèle. Sans elle, la connaissance vient surtout de l’entraînement et s’arrête à une date propre à chaque version. Avec elle, l’assistant lance des requêtes, ouvre des pages et s’en sert comme nouvelles pièces de contexte. Une interface peut activer cette recherche automatiquement, une autre attendre que vous la demandiez. Pour une date, un tarif, une loi, un résultat sportif ou une actualité, ne supposez jamais qu’elle a eu lieu.
Les fichiers, enfin, fournissent une source sous vos yeux : PDF, document, tableur, présentation, image ou capture d’écran, selon le service. C’est probablement l’usage que je conseillerais à quelqu’un qui ne doit en essayer qu’un. Deux réserves : les très gros documents peuvent être découpés et certains passages ratés ; les tableaux mal structurés, avec cellules fusionnées et titres sur trois lignes, sont souvent compris à peu près comme par nous, c’est-à-dire mal. Demandez les pages, les cellules ou les citations qui soutiennent la synthèse.
Le vocal a lui aussi fait un bond. ChatGPT et Claude permettent désormais de parler et d’écouter, de couper la réponse et de reprendre en français. C’est diablement pratique en voiture ou pour réviser une langue. C’est aussi le mode où l’on vérifie le moins ce qu’on nous raconte, parce qu’à l’oral personne n’ouvre les sources. Les transcriptions peuvent par ailleurs rester dans l’historique, selon le service : une conversation orale n’est pas une conversation hors trace.
Les agents : quand il ne répond plus, il fait
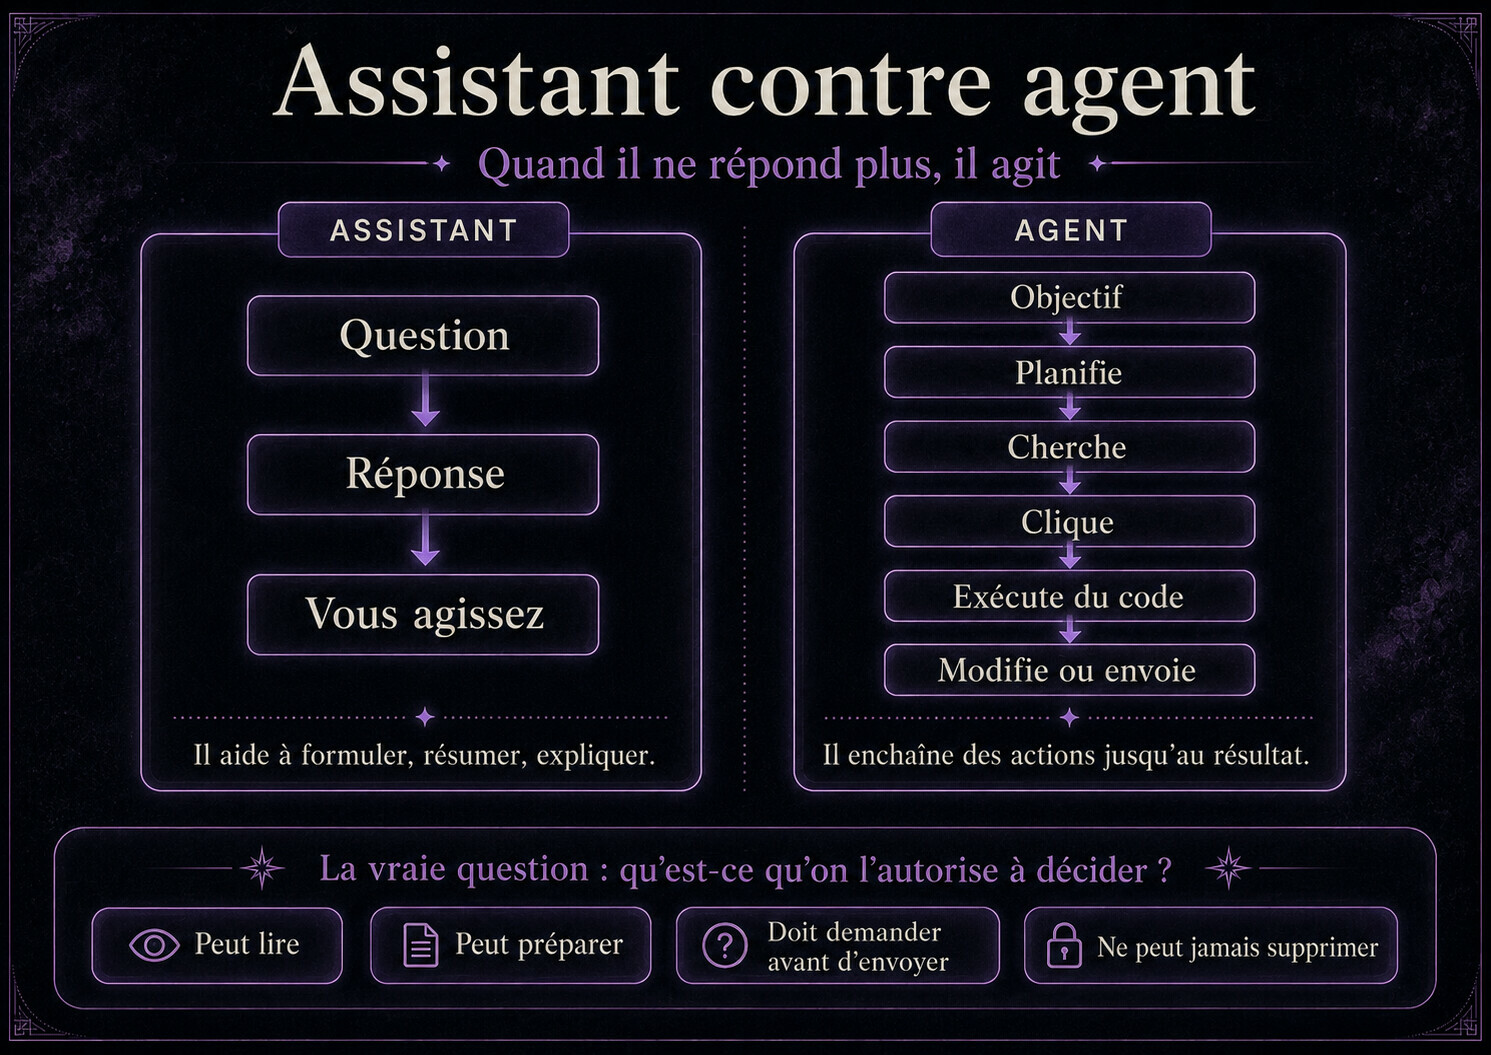
Un agent, c’est le même moteur auquel on a donné des mains : un navigateur, un terminal, des fichiers et parfois l’accès à vos applications. Vous ne demandez plus seulement une réponse, vous donnez un objectif. Le système choisit alors une suite d’actions, cherche sur le web, exécute du code dans un espace isolé, fabrique un document, lit un tableur ou remplit un formulaire.
On les rencontre dans les outils de développement, sous les noms de Claude Code ou Codex, et dans des espaces plus généralistes comme Claude Cowork ou ChatGPT Work. Des connecteurs leur ouvrent Gmail, Drive, Slack, Notion et d’autres services. Le sigle MCP que vous croiserez parfois désigne simplement une façon standard de brancher ces outils à plusieurs assistants.
Sur le papier, c’est le passage de l’assistant au collaborateur. En pratique, souvenez-vous que la machine peut toujours se tromper avec le même aplomb, sauf qu’une erreur qui agit ne coûte pas le même prix qu’une erreur qui bavarde. Un paragraphe faux, on le corrige. Un mail envoyé, un fichier écrasé ou un formulaire validé, beaucoup moins. Ouch.
La bonne question n’est donc pas seulement « est-ce qu’il en est capable ? », mais « qu’est-ce que je l’autorise à décider ? ». Une règle simple : lecture libre, brouillon à relire, envoi sous confirmation. Plus l’action est difficile à annuler, plus l’humain doit revenir dans la boucle.
DR.
Le reste de la boutique mérite un inventaire rapide : génération et retouche d’images, vidéo, recherche approfondie qui lit plusieurs sources avant de rendre un rapport, projets qui rassemblent conversations et fichiers, création de documents, de tableaux ou de présentations. Rien de magique dans cette liste. Le modèle reste au centre ; les outils lui donnent des informations plus fraîches et des moyens d’agir.
À quoi ça sert, concrètement ?
C’est là que l’affaire devient un peu vexante, parce que l’usage moyen reste assez pauvre. Là où ces machines sont franchement utiles, aujourd’hui :
- transformer un format en un autre : des notes en compte rendu, un compte rendu en mail, un mail en trois lignes polies ;
- dépouiller un document et en tirer les points qui vous concernent, à condition de demander les passages correspondants ;
- traduire un premier jet en conservant un ton et un vocabulaire donnés ;
- faire relire un texte en demandant la liste des faiblesses plutôt qu’une réécriture automatique ;
- dégrossir un sujet inconnu, avec une explication pour débutant puis un niveau au-dessus ;
- préparer un entretien, un examen ou une réunion difficile en lui faisant jouer l’autre partie ;
- transformer un tableau de chiffres en graphique commenté, puis vérifier les calculs ;
- écrire un petit programme utile, surtout quand on peut le tester ;
- chercher les objections à votre idée au lieu de vous approuver.
Et la liste inverse, celle des terrains où il faut garder les deux mains sur le volant :
- les chiffres précis, les citations exactes et les références bibliographiques sans source ouverte ;
- le droit, la santé et la fiscalité, tout ce qui vous engage ;
- l’actualité récente si aucune recherche web n’est visible ;
- les données confidentielles, notamment celles de clients, de patients ou de salariés ;
- les calculs importants sans calculateur, code ou autre moyen de contrôle ;
- les actions irréversibles confiées à un agent sans confirmation ;
- vos décisions, tout simplement : il n’a pas d’avis, il a un style.
Pourquoi mes réponses sont-elles si plates ?
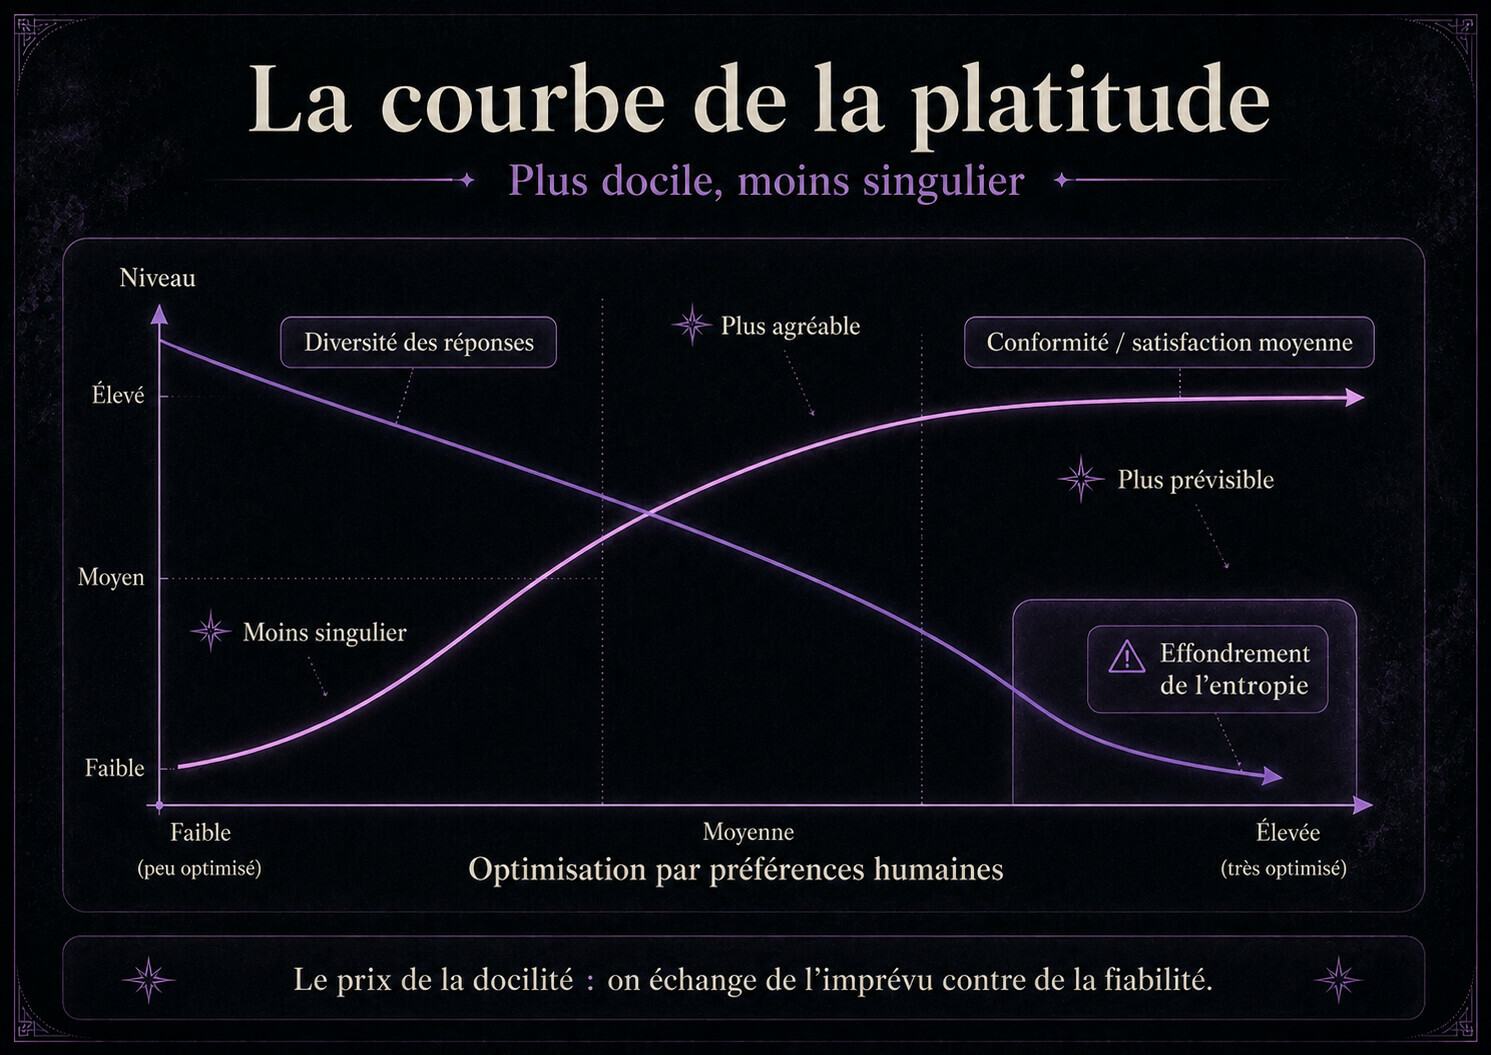
Parce que la question est plate, souvent. Mais il y a une seconde raison : le post-entraînement qui rend la machine serviable lui coûte une partie de sa variété. Quand des juges préfèrent les réponses claires, prudentes et bien rangées, le modèle apprend à produire plus souvent cette moyenne-là. Poussé trop loin, le phénomène porte un nom savant, l’effondrement de l’entropie : le nombre de chemins explorés diminue, et les réponses finissent par se ressembler.
La courbe de la platitude.
Ce que ces courbes décrivent, nous le connaissons par cœur dans les salles de cinéma et les rayons de librairie : un objet qu’on optimise sur la préférence moyenne se met à ressembler à tous les autres. Les groupes de test, les algorithmes de recommandation, les suites et les remakes produisent depuis longtemps la même érosion. Nous disposons maintenant de sa version de laboratoire.
Prenez la commande type : « Écris-moi un article sur le tourisme en Normandie. » On obtient exactement ce qu’on a demandé, un texte que n’importe qui aurait pu écrire, sans relief et sans une ligne à garder. La machine avait raison : c’était bien la moyenne de tout ce qu’elle avait lu sur le sujet.
Ce qui change le résultat tient en quatre réflexes, que le métier appelle l’« ingénierie du prompt » avec un sérieux assez touchant. Donnez le contexte : pour qui, pour quoi, sur quel support. Donnez les contraintes : longueur, ton, informations obligatoires, choses à éviter. Donnez un exemple de ce que vous appelez bon. Et surtout, itérez : indiquez ce qui ne va pas, demandez plusieurs pistes, revenez sur une phrase.
Une commande de départ qui fonctionne
« Je veux [le livrable] pour [le public et le support]. Le but est [l’effet recherché]. Voici le contexte : [les informations utiles]. Respecte [la longueur et les contraintes]. Évite [les défauts]. Avant d’écrire, pose-moi les questions indispensables. Ensuite, propose deux approches et signale ce qui devra être vérifié. »
Une bonne session ressemble moins à un ordre lancé dans une machine qu’à une engueulade constructive. C’est pas sorcier, finalement.
Combien ça coûte, et où sont les murs ?
La grille bouge à peu près tous les trimestres. Au 24 septembre 2026, les prix américains affichés par OpenAI sont de 8 dollars par mois pour Go, 20 dollars pour Plus et à partir de 100 dollars pour Pro. Chez Anthropic, Pro coûte 20 dollars par mois ou 200 dollars par an, et Max existe à 100 ou 200 dollars par mois. Les taxes, la devise, le pays et l’achat par une boutique mobile peuvent changer l’addition. Vérifiez donc la page tarifaire au moment de payer plutôt que de faire confiance, ironie comprise, à un article sur l’IA.
Le premier vrai sujet s’affiche désormais sous certaines réponses. OpenAI a lancé la publicité sur des comptes gratuits et Go, puis étendu le dispositif à plusieurs pays, dont des marchés européens. L’entreprise promet que les réponses restent indépendantes des annonceurs et qu’une offre payante sans publicité restera disponible. Anthropic a pris l’engagement inverse : pas de publicité dans Claude, ni lien sponsorisé ni réponse influencée par un annonceur. Ces promesses méritent d’être relues de temps en temps, elles aussi.
Le second sujet, c’est le compteur. Un abonnement ne donne pas nécessairement un nombre fixe de messages. Une question courte et une longue analyse avec fichiers, raisonnement et outils ne coûtent pas la même chose. Chez Claude, les limites dépendent notamment de la longueur des conversations, du modèle, de l’effort demandé et des fonctions utilisées ; l’usage de Claude sur le web, sur le bureau et dans Claude Code peut puiser dans le même quota. OpenAI emploie lui aussi des limites et des crédits partagés sur certains modes. Quand le mur arrive, il faut attendre, changer de formule ou acheter de l’usage supplémentaire. Ce n’est pas toujours très lisible, même quand la raison technique est défendable.
Troisième sujet, vos données. Sur un compte personnel, ChatGPT permet de désactiver « Améliorer le modèle pour tous » ; Claude propose un réglage comparable d’amélioration du modèle. Les chats temporaires ou incognito sont conçus pour ne pas servir à cet entraînement. Sur les offres professionnelles, les deux entreprises annoncent ne pas entraîner leurs modèles sur les données de l’organisation par défaut.
Attention au mot « entraînement » : ne pas utiliser un contenu pour entraîner un futur modèle ne signifie pas forcément ne rien conserver. Historique, sécurité, obligations légales et règles particulières peuvent imposer une rétention. Anthropic demande par exemple une conservation de trente jours pour certaines utilisations de ses modèles Fable et Mythos les plus avancés. Si un document est vraiment confidentiel, regardez le plan, le modèle, les réglages et le contrat. Et ne collez jamais un mot de passe ou un numéro de carte bancaire dans une conversation, quel que soit le logo.
Au moment où vous lirez ces lignes, deux ou trois choses de ce dossier auront sans doute déjà bougé : un modèle retiré du menu, une fonction renommée, un tarif révisé, peut-être les trois. Reste que l’objet est là, qu’il est bon, et qu’il progresse plus vite que notre capacité à en faire quelque chose d’intelligent.
La question n’est pas de savoir s’il remplacera le rédacteur ou le développeur. Elle est plus embêtante : nous avons désormais sous la main une machine capable de produire, à la demande et pour trois fois rien, la moyenne exacte de tout ce qui a été écrit sur presque n’importe quel sujet. Cette moyenne est correcte. Elle est même souvent meilleure que ce que nous aurions bâclé un soir de bouclage. C’est précisément ce qui devrait nous inquiéter, dans un magazine comme celui-ci.
Le jour où le tiède devient gratuit, seul l’écart a encore de la valeur.
Gageons que nous mettrons un certain temps à en tirer les conséquences.